代码图谱:节点、边与属性
本章要解决的问题
代码事实如何被建模成统一图谱?最小模型需要哪些节点与边?
读者读完应获得什么
- 能为
mini-shop定义节点、边和关键属性。 - 能写出 3 到 5 个有工程价值的查询。
- 能在 JSON/SQLite 与图数据库之间做取舍。
本章不讲什么
- 不绑定唯一图数据库产品。
- 不追求一次覆盖所有语言语义。
代码图谱是软件理解系统的核心数据层。它把结构、关系、行为、演进和组织事实放到可查询模型中。
最小 schema
节点类型
module/file/class/method/test- 可扩展:
route、config、pr、owner
边类型
contains、calls、tests、depends_on- 可扩展:
covers、owns、changed_in
关键属性
id, name, qualified_name
file_path, start_line, end_line
source, confidence, updated_at
mini-shop 实例
完整样例:examples/mini-shop/artifacts/code-graph.json
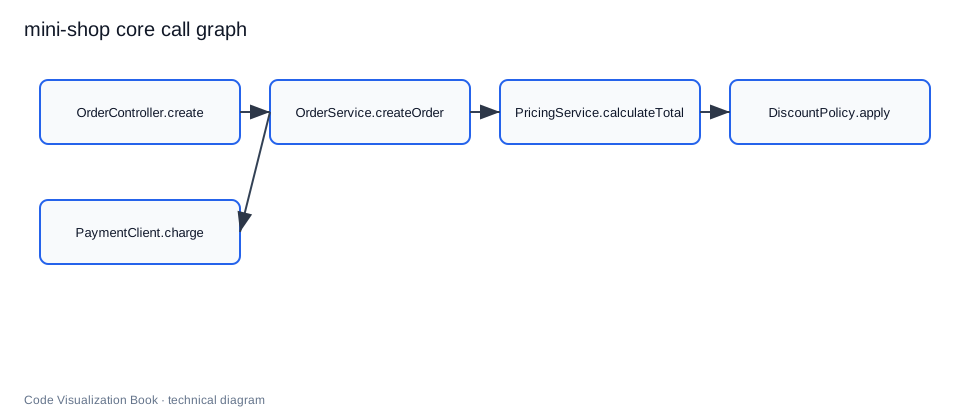
核心调用链:
有工程价值的查询
- find_symbol
DiscountPolicy.apply定义在哪? - find_callers
谁调用了
DiscountPolicy.apply? - impact_analysis 从变更方法出发的反向路径与入口?
- related_tests
哪些测试覆盖该调用链?语义约定:直连该实体的
tests边 ∪ 直连其调用方闭包的tests边——apply直连PricingServiceTest,OrderServiceTest经calculateTotal(apply的调用方)并入。 - architecture_rules
pricing是否依赖payment?
这些查询直接服务 PR 影响面和 Agent 上下文包。
存储取舍
| 方案 | 优点 | 适用 |
|---|---|---|
| JSON 文件 | 简单可讲解 | 教学与最小原型 |
| SQLite | 可 SQL 查询、易分发 | 本地工具 |
| 图数据库 | 深层路径与图算法 | 大规模扩展 |
本书实践优先 JSON/SQLite 讲清模型,图数据库作为扩展。
多源融合原则
同一条 calls 边可能来自静态解析或动态观测。属性中应保留:
sourceconfidenceevidence_refs
冲突时按策略合并,而不是静默覆盖。
从样例 JSON 读模型
examples/mini-shop/artifacts/code-graph.json 中的一条调用边应能直接回答“谁调用谁”:
{
  "type": "calls",
  "from": "method:PricingService#calculateTotal",
  "to": "method:DiscountPolicy#apply",
  "source": "static",
  "confidence": "high"
}
一条测试边应能直接回答“谁锁住该行为”:
{
  "type": "tests",
  "from": "test:PricingServiceTest#shouldApplyVipDiscount",
  "to": "method:DiscountPolicy#apply"
}
一条架构规则应能被自动判定:
{
  "id": "pricing-no-payment",
  "description": "pricing must not depend on payment",
  "from_module": "pricing",
  "forbidden_to_module": "payment"
}
如果这些字段缺失,图谱就只是“能画”,还不能“能审”。
稳定 ID 约定
推荐:
file:<path>
class:<SimpleName>
method:<Class>#<method>
test:<Class>#<method>
要求:
- 同一实体在采集、图谱、影响面、上下文包中 ID 一致
- 重命名时显式迁移 ID 映射,而不是静默生成新 ID
- 低置信解析不得覆盖高置信 ID
PR-42 变更实体 method:DiscountPolicy#apply 必须与图谱、报告全文一致。
工业界已有标准化的符号索引交换格式可直接复用:SCIP(LSIF 的继任者,Sourcegraph 主导,主流代码导航构建其上)把定义/引用/类型索引为可离线分发的产物。实践项目的 JSON 契约教学时够用;接生产系统时,把采集结果对接 SCIP 索引器,能省掉大量自建符号解析工作。
代码图谱不是另一种画法,而是软件理解的数据层合同。节点、边、属性一旦约定不稳,UI、影响面、Agent 工具和验证报告会各自发明一套 ID,最后数字对不上。教学上我们用 JSON 讲清合同;生产上你可以换 SQLite 或图数据库,但合同本身不应推倒重来。
请把“五条金标查询”当成模型验收,而不是附录练习。若 find_callers(apply) 和 related_tests(apply) 都不能稳定回答,图谱再大也只是库存节点,不是理解系统。
局限
- 模型过粗会丢关键语义,过细会难维护
- ID 稳定性决定演进分析能否成立
- 查询性能与增量更新需要工程投入
小结
- 代码图谱用节点/边/属性统一软件事实。
- 最小模型即可支撑影响面与 Agent 查询。
- 查询设计应先于可视化炫技。
- 存储选择服务可复现,而不是先追求规模。
查询体验的最低标准
图谱是否成功,不看节点数,而看能否在 3 次查询内回答:
- 这个符号在哪?
- 谁调用它?
- 哪些测试锁住它?
对 DiscountPolicy.apply,金标答案应稳定可复现。若三次查询仍要靠全文搜索碰运气,说明模型或索引未达标。
工作示例:五个金标查询
| 查询 | 期望 |
|---|---|
| find_symbol(DiscountPolicy.apply) | method 节点 + 文件行号 |
| find_callers(apply) | calculateTotal |
| find_callees(createOrder) | calculateTotal, charge, save |
| related_tests(apply) | PricingServiceTest, OrderServiceTest(直连 + 调用方闭包) |
| architecture_rules(pricing) | pricing-no-payment = pass |
把这五条做成自动化契约测试,实践项目就不会“看起来有图、却不可用”。
常见问题:代码图谱模型
必须上图数据库吗?
教学与早期不必;模型正确优先。
边太多怎么办?
分层、过滤、任务子图,而不是一次画完。
如何防止假精确?
低置信与 unresolved 必须保留。
本章检查清单
- 节点/边/属性是否完整
- 是否有证据字段
- 金标查询是否可过
- 存储取舍是否说明
关键要点复盘
围绕「代码图谱:节点、边与属性」,读者离开本章前应能做到:
- 写出最小节点/边/属性 schema
- 完成 5 条金标查询
- 解释稳定 ID 约定
- 说明 JSON/SQLite/图库取舍
- 衔接到证据可视化
若任一做不到,请先复习本章例子与练习,再继续向后读。
练习
- 为
mini-shop写出 5 个查询及其预期结果。 - 设计
calls边的属性:source/confidence/evidence。 - 比较 JSON 与 SQLite 在教学原型中的优劣。
本章导航
- 上一章:变更分析:系统是如何演进的
- 下一章:可视化表达:从图到证据
- 相关章:变更影响分析与验证;构建代码图谱
延伸阅读与参考资料
- Neo4j data modeling:图建模基础。资料卡:
../docs/research-cards/rc-neo4j-modeling.md - SCIP Code Intelligence Protocol:LSIF 继任者,符号索引交换的工业标准。
- SQLite docs:本地可查询存储。资料卡:
../docs/research-cards/rc-sqlite.md - Joern Code Property Graph:代码属性图概念。
- Graph Data models overview (academic/engineering surveys):图模型取舍补充阅读。
- LSP:符号索引与查询能力对照。资料卡:
../docs/research-cards/rc-lsp.md - 本书样例:
examples/mini-shop/artifacts/code-graph.json。